Cada semana aparece un titular parecido: «El modelo X supera al modelo Y en el benchmark Z». Las redes se llenan de gráficas, de tablas de posiciones y de declaraciones sobre quién va ganando la carrera de la inteligencia artificial. Para quienes investigan y desarrollan estos modelos, esas comparaciones tienen mucho sentido: es la forma de medir el avance de la tecnología con una vara común.
El problema empieza cuando esa misma vara se usa para tomar decisiones de negocio. Sería como contratar a un gerente de ventas únicamente por su calificación en un examen de admisión: dice algo sobre su capacidad, pero casi nada sobre lo que hará en tu empresa, con tus clientes y tus productos. Un modelo puede liderar todas las tablas y, aun así, no aportar nada a tus resultados.
Lo que un benchmark sí mide, y lo que no
Un benchmark es un examen estandarizado: los mismos datos y las mismas preguntas para todos los modelos. Eso lo hace útil para comparar, pero también lo limita. Ese examen no conoce a tus clientes, no sabe cuánto te cuesta equivocarte en cada caso ni cómo trabaja tu equipo. Mide qué tan bien responde el modelo en general, no qué tan bien funciona en tu negocio.
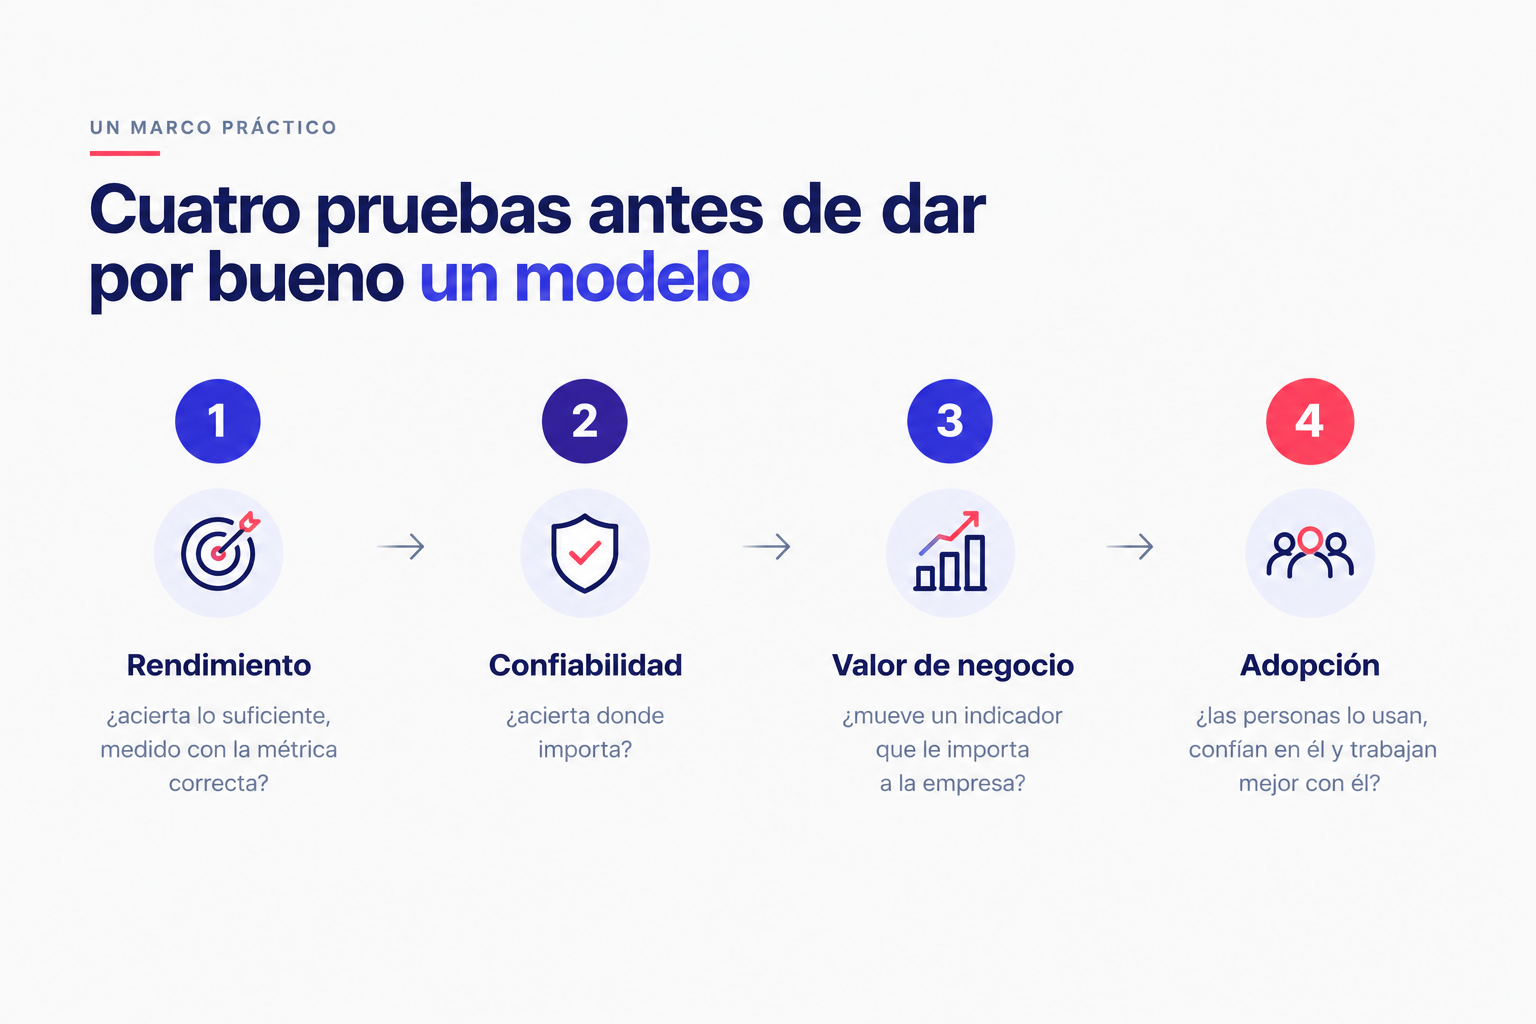
Por eso, cuando una empresa evalúa IA, el rendimiento en una prueba es solo el primer filtro. En lo que sigue recorremos cuatro pruebas que conviene superar, en este orden: el rendimiento técnico, la confiabilidad, el valor de negocio y la adopción.
Las métricas de rendimiento, explicadas sin tecnicismos
Las métricas técnicas dependen de cómo aprende el modelo. No se mide igual un sistema que predice ventas que uno que agrupa clientes o que redacta respuestas. Este es un mapa de las familias más comunes:
| Tipo de aprendizaje | La pregunta que responde | Métricas habituales |
|---|---|---|
| Supervisado: clasificación | ¿Clasifica bien? Por ejemplo, fraude o no fraude, cliente que se va o se queda. | Accuracy, precision, recall, F1, AUC |
| Supervisado: regresión | ¿Qué tan cerca están sus estimaciones del valor real (ventas, demanda, precios)? | MAE, RMSE, R² |
| No supervisado | ¿Encontró grupos o patrones con sentido en datos sin etiquetas, como segmentos de clientes? | Silhouette, índice Davies-Bouldin, validación con expertos |
| Semisupervisado | ¿Aprovecha pocos datos etiquetados y muchos sin etiquetar sin perder calidad? | Las mismas del aprendizaje supervisado, medidas sobre un conjunto etiquetado aparte |
| Por refuerzo | ¿Aprendió una estrategia que mejora los resultados con el tiempo, como precios dinámicos, rutas o inventario? | Recompensa acumulada, tasa de éxito, estabilidad |
| Autosupervisado y generativo (LLMs) | ¿Genera texto, código o imágenes útiles y correctas? | Perplejidad, ROUGE y BLEU, evaluación humana o por rúbrica, benchmarks estándar |
Los benchmarks que dominan los titulares sobre modelos de lenguaje pertenecen a la última fila.
Las métricas de clasificación son las que más aparecen en las conversaciones de negocio, y también las que más se malinterpretan:
Accuracy (exactitud). El porcentaje de casos que el modelo acierta. Es la más intuitiva y la más engañosa. Si solo el 1% de las transacciones es fraude, un modelo que siempre responde «no hay fraude» tiene 99% de accuracy y no detecta un solo fraude.
Precision. De todas las alertas que lanzó el modelo, ¿cuántas eran reales? Una precision baja significa muchas falsas alarmas y un equipo perdiendo tiempo en revisarlas.
Recall (sensibilidad). De todos los casos reales que existían, ¿cuántos encontró? Un recall bajo significa casos importantes que se le escapan.
F1. Un solo número que equilibra precision y recall, útil cuando no quieres optimizar una a costa de la otra.
AUC. Mide qué tan bien el modelo ordena los casos, poniendo los de mayor riesgo por encima de los de menor riesgo, sin depender de dónde se fije la línea de corte. Un valor de 0.5 equivale a lanzar una moneda; 1.0 es un modelo perfecto.
En regresión, el MAE te dice cuánto se equivoca el modelo en promedio, en las mismas unidades que tu negocio (pesos, unidades, días), y el RMSE hace lo mismo pero castiga con más fuerza los errores grandes.
Todas estas métricas son legítimas y necesarias, pero responden a una sola pregunta: ¿acierta el modelo sobre un conjunto de datos de prueba? Lo que decide si una IA sirve para tu empresa es todo lo que viene después.
Confiabilidad: el promedio puede engañar
Un número único para toda la empresa es cómodo de reportar y peligroso de interpretar. Cuando un modelo se evalúa como si el negocio fuera una sola unidad, los buenos resultados en las áreas fáciles compensan los malos resultados en las difíciles, y el promedio resultante no describe a ninguna de las dos.
Veamos un ejemplo ilustrativo, con cifras hipotéticas, de un modelo que predice qué clientes comprarán en el próximo trimestre:
| Segmento de clientes | % de los casos | % de los ingresos | Accuracy |
|---|---|---|---|
| Comercio en línea | 50% | 20% | 97% |
| Tiendas físicas | 30% | 25% | 92% |
| Clientes corporativos | 20% | 55% | 75% |
| Total | 100% | 100% | 91% |
Ejemplo ilustrativo con datos hipotéticos.
El reporte general dice que el modelo acierta el 91% de las veces, un resultado que cualquier comité aprobaría. Pero en los clientes corporativos, que generan más de la mitad de los ingresos, acierta solo tres de cada cuatro veces. El promedio se ve bien porque los segmentos fáciles son los más numerosos, no porque el modelo funcione donde más importa.
Evaluar por segmentos cambia la pregunta de «¿cuánto acierta?» a «¿dónde acierta y dónde falla?». Los cortes más útiles dependen de cada negocio: por línea de producto, por tipo o tamaño de cliente, por región, por canal de venta, por antigüedad del cliente o por temporada. Un modelo confiable no es el que tiene el mejor promedio, sino el que mantiene un desempeño aceptable en cada una de las áreas que sostienen el negocio.
Valor de negocio: traducir el error a dinero
Un modelo puede ser técnicamente excelente y económicamente irrelevante. El valor de negocio se mide en otro idioma: ingresos, costos, tiempo y riesgo. Y la forma de llegar a él empieza por reconocer que los errores no cuestan lo mismo.
Piensa en un modelo que identifica clientes a punto de abandonarte. Si llama a un cliente que no se iba a ir, pierdes una llamada. Si deja ir a un cliente que sí se iba, pierdes su valor durante años. Cuando el segundo error cuesta cincuenta veces más que el primero, el mejor modelo no es el que tiene la métrica más alta, sino el que está calibrado para preferir llamar de más a dejar escapar a alguien. Esa decisión no sale de ningún benchmark; sale de conocer tus costos.
Para que la evaluación tenga sentido en términos de negocio, hay cuatro preguntas que conviene responder desde el inicio:
¿Qué indicador debe mover? Ingresos adicionales, costos evitados, horas ahorradas, tiempo de respuesta, tasa de conversión o retención de clientes. Si no se puede nombrar, el proyecto no tiene una meta.
¿Frente a qué se compara? El punto de comparación no es «sin nada», sino el proceso actual: las reglas que hoy se aplican, la hoja de cálculo, el criterio de un analista. Un modelo vale lo que mejora sobre esa línea base, no lo que logra en el vacío.
¿Cuánto mejora, traducido a dinero? Dos puntos más de F1 son una cifra abstracta. Cuántos clientes más se retienen, cuántas horas se liberan o cuántos fraudes se evitan es una cifra que un director financiero puede evaluar.
¿A qué costo? El retorno de la inversión incluye todo lo que hay que pagar para obtener ese beneficio: licencias, datos, integración, mantenimiento y tiempo del equipo. Un modelo que mejora un 2% pero cuesta el triple puede ser una mala decisión aunque gane todas las competencias.
Adopción y experiencia humana: el valor que se decide en el día a día
Existe un último filtro que ninguna prueba de laboratorio puede medir: que las personas realmente usen el modelo. Una IA con 90% de aciertos que tu equipo ignora genera exactamente el mismo valor que una que no existe. Por eso el impacto real se parece más a una multiplicación que a una suma: rendimiento del modelo, por la proporción de decisiones en las que efectivamente se usa, por el valor de cada una de esas decisiones.
La adopción se puede medir, y las señales más reveladoras son pocas y concretas:
Tasa de uso. Cuántas de las personas que podrían usar la herramienta lo hacen, y si siguen haciéndolo a los 30 y a los 90 días.
Tasa de aceptación. Con qué frecuencia el equipo sigue la recomendación del modelo, y con qué frecuencia la corrige o la descarta. Un nivel alto de correcciones es una señal temprana de que algo no encaja, aunque las métricas técnicas se vean bien.
Tiempo y esfuerzo. Cuánto tarda una tarea con el modelo frente a sin él, y si el equipo siente que la herramienta le quita trabajo o se lo añade.
Confianza. Si las personas saben cuándo apoyarse en el modelo y cuándo aplicar su propio criterio. Un equipo que confía ciegamente es tan riesgoso como uno que desconfía de todo.
Detrás de estas señales hay una verdad sencilla: incorporar IA cambia la forma de trabajar de personas reales. La capacitación, el acompañamiento y el diseño de la herramienta alrededor del flujo de trabajo existente pesan tanto como la calidad del modelo.
Un marco práctico: cuatro pruebas antes de dar por bueno un modelo
Al juntar todo lo anterior, la evaluación de un modelo de IA para negocio se resume en cuatro pruebas. Cada una depende de la anterior, y fallar en cualquiera de ellas es razón suficiente para detenerse y ajustar antes de escalar.
-
1
Rendimiento: ¿acierta lo suficiente, medido con la métrica correcta?
Elige la métrica según el tipo de problema y según el costo de cada error, no por ser la más popular. Es la prueba de entrada, no la de salida.
-
2
Confiabilidad: ¿acierta donde importa?
Evalúa por producto, cliente, región y canal. Un buen promedio no sirve si el modelo falla en los segmentos que sostienen el negocio.
-
3
Valor de negocio: ¿mueve un indicador que le importa a la empresa?
Compara contra el proceso actual, traduce la mejora a dinero, tiempo o riesgo, y réstale el costo total de obtenerla.
-
4
Adopción: ¿las personas lo usan, confían en él y trabajan mejor con él?
Mide uso sostenido, aceptación de las recomendaciones y el efecto real sobre el trabajo diario del equipo.
Antes de elegir el modelo, define cómo vas a juzgarlo
Lo más útil de este marco es que funciona al revés de como suele hacerse. En lugar de elegir el modelo que lidera las tablas y luego buscar dónde aplicarlo, conviene empezar por las cuatro pruebas: qué indicador de negocio debe mover, en qué segmentos es crítico que funcione, qué error es más caro y cómo se va a incorporar al trabajo del equipo. Con esas respuestas en la mano, la comparación entre modelos deja de ser una carrera de titulares y se convierte en una decisión informada.
Los benchmarks seguirán apareciendo cada semana, y está bien que así sea: son una señal valiosa del avance de la tecnología. Pero son el punto de partida de la conversación, no su conclusión.
«Un benchmark te dice qué tan bueno es un modelo. Tu negocio te dice qué tan bueno es para ti.»
Sobre el autor: Carlos Carrasco es CTO de Evolvis AI. Es Doctor en Sistemas Inteligentes por el Tecnológico de Monterrey, candidato a MBA y ex investigador senior del Barcelona Supercomputing Center. Cuenta con más de 20 publicaciones científicas y ha liderado proyectos de gran escala, impulsando el desarrollo y la aplicación de inteligencia artificial en diversas industrias.
Contacto: info@evolvis.ai
